Assume Breach statt „Accept Breach“: Datenflüsse und Vertrauenszonen kontrollieren
Aus der Berliner Verwaltung sind 5,8 Terabyte teils hochsensible Daten im Darknet aufgetaucht – nicht wegen einer verweigerten Lösegeldzahlung, sondern weil die Angreifer die Daten exfiltrieren konnten. Organisationen können nicht jeden Angriff verhindern. Sie können aber Datenflüsse kontrollieren, Vertrauenszonen trennen und Inhalte vor Netzübergängen prüfen.
Wer seine IT verteidigt, arbeitet unter anderen Bedingungen als der Angreifer. Drei Punkte prägen diese Ausgangslage:
- Regulierung bindet nur die Verteidiger. Angreifer halten sich nicht an Vorgaben wie die Datenschutz-Grundverordnung (DSGVO), den Cyber Resilience Act (CRA) oder den Arbeitsschutz. Wer diese Vorgaben einhält, ist insoweit im Nachteil.
- Rechtliche Sanktionen wirken nicht abschreckend. Angreifer wissen, dass sie sich nach nationalem Recht strafbar machen, nehmen das aber aus unterschiedlichen Gründen in Kauf.
- Kommerziell motivierte Angriffe können politisch und reputativ wirken. Ihre Folgen können länger nachwirken als die einer Lösegeldzahlung. Weil auch staatliche Akteure einträgliche Geschäfte betreiben, muss der eigene Schutz ebenso gegen sie wirken.
Daraus folgt nicht, dass Organisationen den Diebstahl vertraulicher Daten akzeptieren müssen. Grundlage der Gegenmaßnahmen ist ein datenzentriertes und nutzerzentriertes Vorgehen – und das beginnt bei der Frage, welche Daten überhaupt welchen Schutz brauchen.
Nicht alle Daten sind gleich vertrauenswürdig
Ein häufiger Fehler besteht darin, alle Daten in einen Topf zu werfen und nur diesen „Topf“ zu verteidigen. In der Datenmenge einer Organisation liegen immer Daten unterschiedlicher Vertrauenswürdigkeit. Ein behandelnder Arzt etwa erhält von Patienten Messwerte aus Gesundheitsgeräten, kann aber nicht beurteilen, ob diese Geräte zugelassen sind oder dem CRA entsprechen. Solche Daten können schädlichen Code enthalten.
Vergleichbare Konstellationen finden sich in vielen Branchen: Versicherungsunternehmen, die Bilder und Videos von zu regulierenden Schäden annehmen, Energieversorger, die Fotos von Strom- und Gaszählern erhalten, HR-Abteilungen mit E-Mails unbekannter Absender. In der Betriebstechnik spielen Dienstleister Updates auf und Verfahren nach dem Onlinezugangsgesetz (OZG) akzeptieren Dokumente von Bürgern.
Weitere Datenquellen nehmen Organisationen kaum als solche wahr: Überwachungskameras, smarte Fernseher, Lautsprecher mit Sprachassistenten oder Drohnen mit WLAN-Verbindung verfügen über Datenübergabeschnittstellen oder sind direkt vernetzt. Mobile Datenträger wie USB-Sticks, Smartphones und Wearables bringen Daten ins Hausnetz. Nicht zuletzt werden über jeden Browser Daten geladen und potenziell versendet – bewusst oder unbewusst.
Grenzen der Erkennung
Schädlicher Code kann sich in jedem Datentyp verbergen: in Bildern und Office-Dokumenten ebenso wie in Videos oder Konstruktionszeichnungen. Dabei nutzt er nicht nur Makros oder sichtbare Elemente, sondern kann auch eingebettet, verschleiert oder verschlüsselt vorliegen.
Viele bekannte Angriffe folgen einem ähnlichen Muster. Ein kleines Datenpaket mit schädlichem Code gelangt auf ein verwundbares System und verbreitet sich von dort weiter – die sogenannte laterale Bewegung. Was der Code anschließend ausführt, ist unterschiedlich. Er kann auf Anweisungen eines Command-and-Control-Servers warten, Daten stehlen, verschlüsseln oder vernichten sowie Konfigurationen verändern.
In dieser Vielfalt liegt das Erkennungs- und Zuordnungsproblem. Anti-Viren-Systeme können Schadcode erkennen, sofern er unverschlüsselt vorliegt. Sie können schädlichen Code aber nicht
von legitimem Code unterscheiden, den etwa die eigenen Administratoren erstellt haben. An den Netzübergängen muss deshalb untersucht werden, ob die übertragenen Daten verschlüsselte Inhalte oder Code enthalten. Identifizierte verschlüsselte Inhalte müssen – ebenso wie Archive – rekursiv entschlüsselt und entpackt werden. Erst im Klartext lassen sie sich der Content-Analyse zuführen.
Daten vor der Nutzung bereinigen
Damit Nutzer und Fachverfahren die Daten erhalten, die sie benötigen, müssen „verschmutzte“ Daten „gewaschen“ beziehungsweise „desinfiziert“ werden. Ein Foto einer illegalen Tat bleibt für die Polizei ein Beweismittel, auch wenn das Gerät des Zeugen mit einem Virus infiziert war.
Gleiches gilt für Schadensfotos bei Versicherern oder Immobilienfotos für Verkaufsexposés. Datenwäsche bezeichnet den Vorgang, an einem Netzübergang aus einem Datenpaket, das die Sicherheitsrichtlinie des Zielnetzes verletzt, ein regelkonformes Paket herzustellen. Nicht erwünschte Code-Elemente werden entfernt, alle erlaubten – signiert oder im Whitelisting-Verfahren freigegeben – bleiben enthalten.
Bei der Datenwäsche werden nicht erwünschte Codeelemente entfernt; alle erlaubten bleiben enthalten.
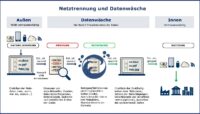
Jeder Waschvorgang muss dokumentiert werden. Das Dokument erhält einen „Beipackzettel“ in seinen Metadaten, der das Ergebnis, etwaige Veränderungen und den Speicherort des Originals enthält.
Netzgrenzen an Datenklassen ausrichten
Ein einzelner Perimeterschutz aus entmilitarisierter Zone (Demilitarized Zone, DMZ) und Firewall erreicht kein ausreichendes Schutzniveau. Sobald unbekannte oder verschlüsselt übertragene Daten – etwa wegen der Verschlüsselung personenbezogener Daten – unmittelbar ins innere Netz gelangen, besteht Handlungsbedarf.
Organisationen sollten Daten daher entsprechend ihrer Vertrauenswürdigkeit in getrennten Netzsegmenten verarbeiten. Eine laterale Bewegung schädlicher oder verschmutzter Daten richtet dann nur innerhalb derselben Datenklasse geringen Schaden an und kann nicht auf Klassen höherer Vertrauenswürdigkeit übergreifen. Statt eines großen Datenozeans entstehen mehrere kleinere, virtualisierte Seen. Cloud-Instanzen helfen dabei, sofern die jeweilige Cloud die notwendigen regulatorischen Anforderungen erfüllt.
Ein Beispiel aus der Schadensregulierung verdeutlicht das. Zugelieferte Daten landen zunächst in einem Datenraum, der als schmutzig gilt. Der Transport dorthin erfolgt Ende-zu-Ende-verschlüsselt und berücksichtigt so Vertraulichkeit und die Datenschutz-Grundverordnung (DSGVO). Beim Übergang in das Auswertungsnetz wäscht das System die Daten automatisch.
Die Netztrennung setzen Betreiber physisch oder über virtuelle lokale Netze (Virtual Local Area Network, VLAN) um. Die Mechanismusstärke der netztrennenden Elemente und der Waschprogramme richtet sich nach den erwarteten Angriffen, der Kritikalität der Daten und dem eigenen Risikoappetit. Die höchste Stufe bildet ein Air Gap. Dort muss zusätzlich sichergestellt sein, dass niemand einen Datenträger nacheinander an beide Seiten anschließt. Sonst gelangen Angriffe über dessen Firmware in die geschützten Systeme.
Auch ausgehende Daten brauchen Kontrollen
Die beschriebenen Verfahren wirken in beide Richtungen. Greifen Anwender auf Daten aus unsicheren Datenräumen zu, passieren diese Daten zunächst Netztrennung, Content-Analyse und Wäsche, bevor sie im Arbeitsnetz ankommen. Dort lassen sie sich mit vorhandenen Beständen zusammenführen und weiterbearbeiten.
Auf dem Weg nach draußen greifen dieselben Prüfungen, allerdings mit einem anderen Ziel. Hier geht es nicht um Schadcode, sondern um Vertraulichkeit. Vor der Übergabe in eine unsichere Umgebung entfernt oder verdeckt das Gateway sensible Inhalte, etwa durch Sanitarisierung, Schwärzen oder Data Leakage Prevention (DLP).
Ramon Mörl ist Geschäftsführer der itWatch GmbH.
Newsletter Abonnieren
Abonnieren Sie jetzt IT-SICHERHEIT News und erhalten Sie alle 14 Tage aktuelle News, Fachbeiträge, exklusive Einladungen zu kostenlosen Webinaren und hilfreiche Downloads.